

Databricks tréning
Egynapos intenzív tréning: adatfeldolgozás és pipeline-építés Databricks és PySpark alapokon, a nyers adatoktól a Medallion architektúráig.
Mit nyújt a Databricks tréning?
Modern data engineering szemléletet kapsz
Megérted, hogyan jut el az adat a különböző forrásrendszerekből a riportinghoz, analitikához vagy AI-felhasználáshoz szükséges strukturált adatkészletekig, és átlátod az adatbetöltés, tisztítás, transzformáció és tárolás szerepét egy teljes folyamatban.
Gyakorlati Databricks-ismereteket szerzel
Megismered a Databricks workspace, a notebookok, a táblák, a fájlok és a compute erőforrások működését, és nemcsak bemutatót látsz, hanem saját környezetben dolgozol.
Lakehouse szemléletet sajátítasz el
Megérted a data lake, a data warehouse és a lakehouse közötti különbségeket, valamint azt, hogy a Databricks hogyan egyesíti a rugalmas adattárolást a strukturált és megbízható analitikai feldolgozással.
Adatminőségi szemléletet és PySpark alapokat kapsz
Gyakorlati példákon keresztül használod a Spark DataFrame-eket (select, filter, withColumn, groupBy, join), és megtanulod felismerni a gyakori adatminőségi problémákat.
Mini data pipeline építési tapasztalatot szerzel
Egy összefüggő mini projektet építesz fel, amely a nyers adatbetöltéstől a tisztításon és transzformáción át (Bronze, Silver rétegek) egy üzletileg értelmezhető Gold kimenetig vezet.
Miért érdemes belevágnod?
Sokan érdeklődnek a data engineering iránt, de egy több hónapos, mélyebb képzés komoly idő, pénzügyi és mentális elköteleződés. Nehéz előre eldönteni, hogy tényleg vonz e a technikai adatfeldolgozás és az SQL/Python alapú munka, mielőtt belevágnál egy hosszabb útba.
Ez a workshop pont ezt a bizonytalanságot oldja meg: rövidebb, kisebb elköteleződést kérő, mégis kifejezetten gyakorlati belépő. Nem általános gyorstalpalóról van szó, hanem egy konkrét, piacképes irányra fókuszálunk, amit egyre több vállalati adatkörnyezetben használnak: a Databricksre és a PySparkra.
A workshop végére a lakehouse és a medallion architektúra (Bronze/Silver/Gold) nem marad puszta elmélet: saját Databricks notebookkal és egy működő mini data pipeline-nal távozol, plusz egy tisztább szakmai képpel arról, hogyan működik a modern data engineering a gyakorlatban.
- Munka mellett végezheted, rugalmas időbeosztással
- Gyakorlati projekteken keresztül, oktatói mentorálással
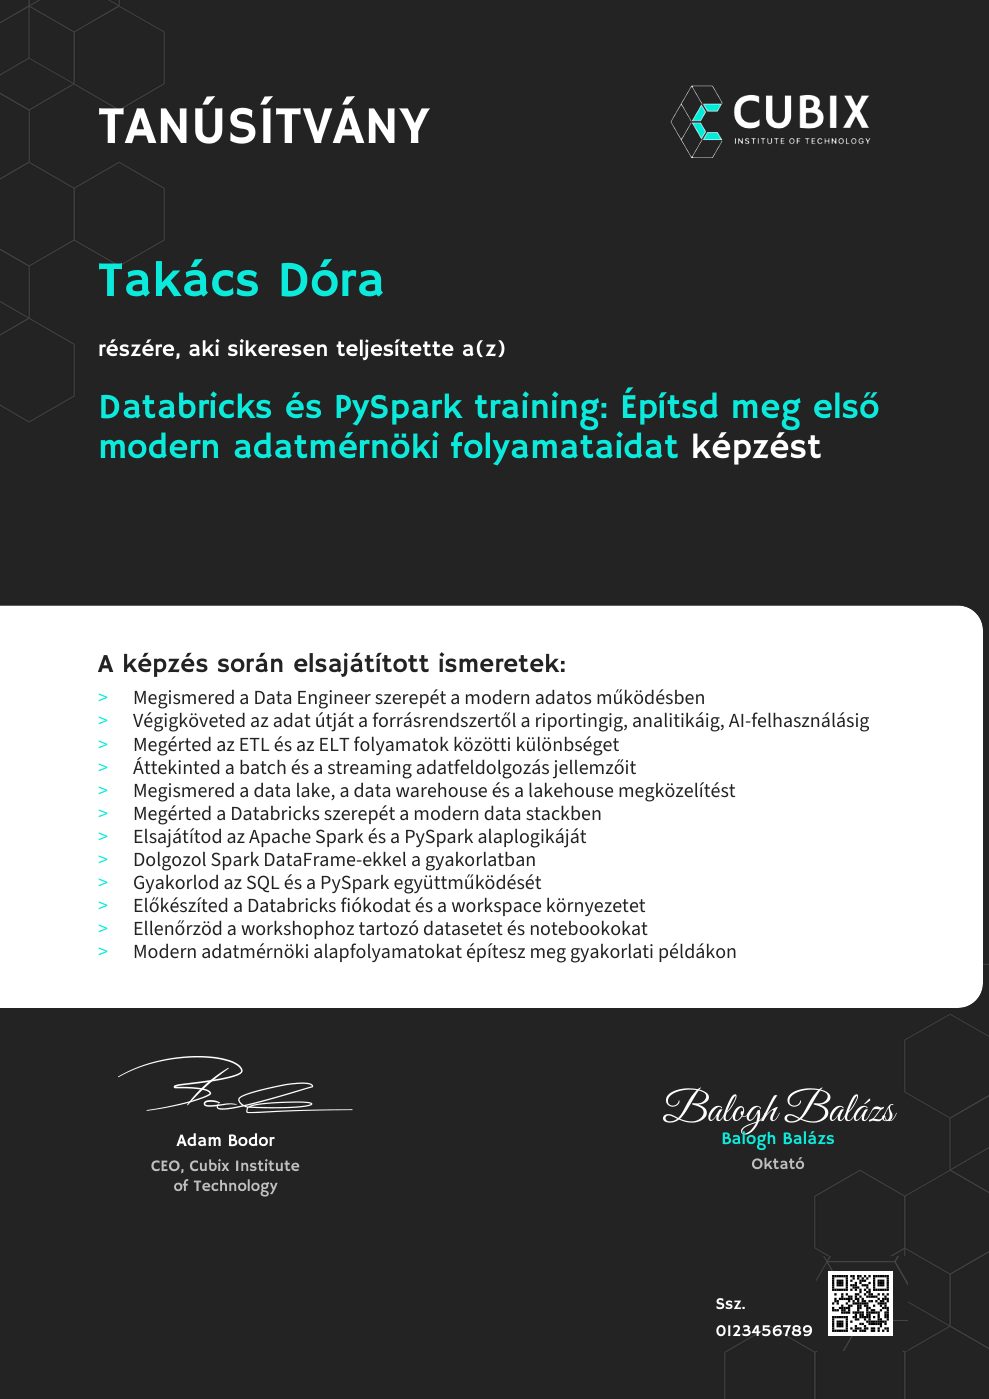
- LinkedIn profilodba beágyazható tanúsítvány
Ismerd meg oktatódat

Balogh Balázs
Senior Data Engineer, ALDI International IT Services
Data Engineerként adatvezérelt megoldások fejlesztésével foglalkozom, jelenleg egy nemzetközi vállalat adatminőségi csapatában dolgozom. Python, PySpark, SQL és Azure technológiákkal építek adatmegoldásokat: ETL folyamatokat fejlesztek, rendszerek közötti integrációkat biztosítok, és Power BI dashboardokat készítek, hogy a döntéshozók valós időben lássák az adatokat.
A szakmai munkám mellett a közösségépítésben is aktív vagyok: én szervezem a Budapest.py meetup csoportot. Hiszek az élethosszig tartó tanulásban, és célom, hogy az adatok mellett a tudást is hatékonyan adjam át.
Kinek ajánlott?
- Data és Business Analysteknek, akik szeretnék megérteni, hogyan készülnek el a háttérben az általuk használt adatkészletek és az üzleti riportok mögötti technikai folyamatok
- BI- és Power BI-szakembereknek, akik a vizualizáció és riportkészítés mellett szeretnének közelebb kerülni az adatbetöltéshez és a transzformációhoz
- SQL-felhasználóknak és Junior data szakembereknek, akik szeretnének továbblépni az összetettebb adatfeldolgozási folyamatok és a modern adatplatformok (Databricks, PySpark) irányába
- Céges data, BI, reporting és IT csapatoknak, amelyek közös technológiai alapot szeretnének kialakítani a modern data pipeline-ok működéséről
Mik a képzés előkövetelményei?
Kötelező
- Alapvető SQL-tudás: magabiztosan érted és használod a SELECT, WHERE, GROUP BY és JOIN műveleteket
- Adatos gondolkodás: van tapasztalatod táblázatos vagy adatbázisban tárolt adatok értelmezésében
- Olyan eszköz, amelyre a kurzushoz szükséges programokat fel tudod majd telepíteni
- A workshop előtti technikai felkészülés: a kapott checklist alapján a regisztrációs, belépési és környezetbeállítási lépések elvégzése
Előny, de nem feltétel
- A Python alapvető szintaxisának ismerete Megkönnyíti a PySpark-példák követését, magabiztos fejlesztőnek nem kell lenned.
Hogyan fogsz tanulni?
Modern data engineering szemléletet
Megérted, hogyan jut el az adat a különböző forrásrendszerekből a riportinghoz, analitikához vagy AI-felhasználáshoz szükséges strukturált adatkészletekig. Átlátod az adatbetöltés, tisztítás, transzformáció és tárolás szerepét egy teljes folyamatban.
Gyakorlati Databricks-ismereteket
Megismered a Databricks workspace, a notebookok, a táblák, a fájlok és a compute erőforrások működését. A workshop során nemcsak bemutatót látsz, hanem saját környezetben dolgozol.
Lakehouse szemléletet
Megérted a data lake, a data warehouse és a lakehouse közötti különbségeket, valamint azt, hogy a Databricks hogyan egyesíti a rugalmas adattárolást a strukturált és megbízható analitikai feldolgozással.
Adatminőségi szemléletet és PySpark alapokat
Gyakorlati példákon keresztül használod a Spark DataFrame-eket (select, filter, withColumn, groupBy, join). Megtanulod felismerni a gyakori adatminőségi problémákat.
Mini data pipeline építési tapasztalatot
Egy összefüggő mini projektet építesz fel, amely a nyers adatbetöltéstől a tisztításon és transzformáción át (Bronze, Silver rétegek) egy üzletileg értelmezhető Gold kimenetig vezet.
Minőségbiztosított képzések
Képzéseink szakmai minőségbiztosítását iparági vezető technológiai vállalatok végzik. Szakmai partnerünk a Budapesti Műszaki és Gazdaságtudományi Egyetem Villamosmérnöki és Informatikai Kara.
- Tanúsítványt kapsz, amelyet önéletrajzodhoz és LinkedIn profilodhoz csatolhatsz
- Bizonyítja, hogy elsajátítottad az adott ismereteket
- Segíti a szakmai előmeneteledet és karriered fejlődését
Jó társaságban leszel!
Már több mint 150 hazai és nemzetközi cég munkatársa képezte magát tovább nálunk.

Tudtad?
A munkáltatók 83%-a finanszírozza a munkatársak képzését, ne felejtsd el megkérdezni a tiédet!
Jelenleg nincs meghirdetett indulási dátum
Érdekel a képzés?
Add meg az e-mail címed, és szólunk, amint meghirdetjük a következő indulást.
Fizetési lehetőségek
Többféle fizetési lehetőséget biztosítunk, hogy a számodra legmegfelelőbb opciót választhasd.
Online fizetés bankkártyával
A Stripe az egyik legelterjedtebb online fizetési megoldás nemzetközileg, gyors és biztonságos fizetési folyamatáról ismert.
Fizetés banki átutalással, egy összegben
Ha online kártyás fizetés helyett banki átutalással szeretnél fizetni, az sem probléma, lent található jelentkezési űrlapunkon ezt is választhatod.
Kapcsolódó képzések
A Databricks és PySpark alapok mellé a data engineering, illetve az SQL- és a Python-alapozás is kapcsolódik. Bármelyik hozzáadható a jelentkezésedhez.
Készen állsz a jelentkezésre?
Könnyítendő magánszemélyként résztvevő hallgatóink helyzetét, a feltüntetett ár számukra a ténylegesen fizetendő végösszeg. Céges megrendelés esetén az adott összeg tekintendő a nettó árnak.
Mit fogsz tanulni?
1 nap alatt a modern data engineering alapfogalmaitól a Spark DataFrame-műveleteken át egy működő mini data pipeline felépítéséig (Bronze, Silver, Gold rétegek).
1 A Workshop fő témái A modern data engineering alapfogalmaitól a Databricks-környezet előkészítésén át a PySpark-alapú adatfeldolgozásig.
- A Data Engineer szerepe a modern adatos működésben
- Az adat útja a forrásrendszertől a riportingig, analitikáig vagy AI-felhasználásig
- ETL- és ELT-folyamatok
- Batch és streaming adatfeldolgozás
- Data lake, data warehouse és lakehouse megközelítés
- A Databricks szerepe a modern data stackben
- Apache Spark és PySpark alaplogika
- Spark DataFrame-ek
- SQL és PySpark együttműködése
- Databricks-account és workspace előkészítése
- A dataset és a szükséges notebookok ellenőrzése
Gyakran Ismételt Kérdések
Mi az a Databricks, és mire használják?
A Databricks egy felhőalapú adatplatform, amely az Apache Sparkra épül. Egy helyen végezheted rajta az adatok betöltését, tisztítását, átalakítását és elemzését, és a gépi tanulási projektek is erre épülhetnek. Az Azure, az AWS és a Google Cloud felhőjében is elérhető. A tréningen megismered a workspace, a notebookok, a táblák és a compute erőforrások működését, és a saját környezetedben dolgozol.
Mi az a PySpark, és miben más, mint a Pandas?
A PySpark az Apache Spark Python felülete: Python kóddal írsz vele adatfeldolgozást, amely több gépen elosztva, nagy adatmennyiségen is lefut. A Pandas egyetlen gép memóriájában dolgozik, ezért a kisebb adatkészletekhez kényelmes, a PySpark pedig a nagy, vállalati adatokhoz való. A tréningen a Spark DataFrame-ek alapműveleteit gyakorlod (select, filter, withColumn, groupBy, join).
Mi az a data lakehouse?
A lakehouse a data lake és a data warehouse előnyeit ötvözi. Rugalmasan tárolja a nyers adatokat, közben pedig strukturált, megbízható táblákat ad az elemzéshez és a riportokhoz. Gyakori felépítése a Medallion architektúra, ahol az adat a nyers Bronze rétegből a tisztított Silver rétegen át az üzletileg értelmezhető Gold rétegig jut. A tréningen ezt a folyamatot egy saját mini pipeline-on építed fel.
Miben más a Databricks, mint a Snowflake?
A Snowflake felhőalapú adattárházként indult, és elsősorban az SQL-alapú elemzésre és riportolásra épít. A Databricks a Sparkból nőtt ki, ezért a nagy mennyiségű adat programozott feldolgozása, a data engineering és a gépi tanulás az erőssége, és a lakehouse megközelítést követi. Az utóbbi években mindkét platform a másik területe felé is bővült, ezért a választás sokszor a csapat meglévő eszközein és céljain múlik.
Milyen előismeret kell a Databricks tréninghez?
Alapvető SQL-tudás kell: magabiztosan használd a SELECT, WHERE, GROUP BY és JOIN műveleteket, és legyen tapasztalatod táblázatos vagy adatbázisban tárolt adatok értelmezésében. A Python alapszintaxisának ismerete megkönnyíti a PySpark-példák követését, de nem feltétel, és magabiztos fejlesztőnek sem kell lenned. A workshop előtt a kapott checklist alapján elvégzed a regisztrációt és a környezet beállítását.