Képfelismerés saját deep learning modellel vagy multimodális LLM-mel?
Multimodális LLM vagy saját képfelismerő modell? Egy hazai üzem példáján mutatjuk meg, hogyan dönthetünk a hibák, a válaszidő és a teljes költség alapján.
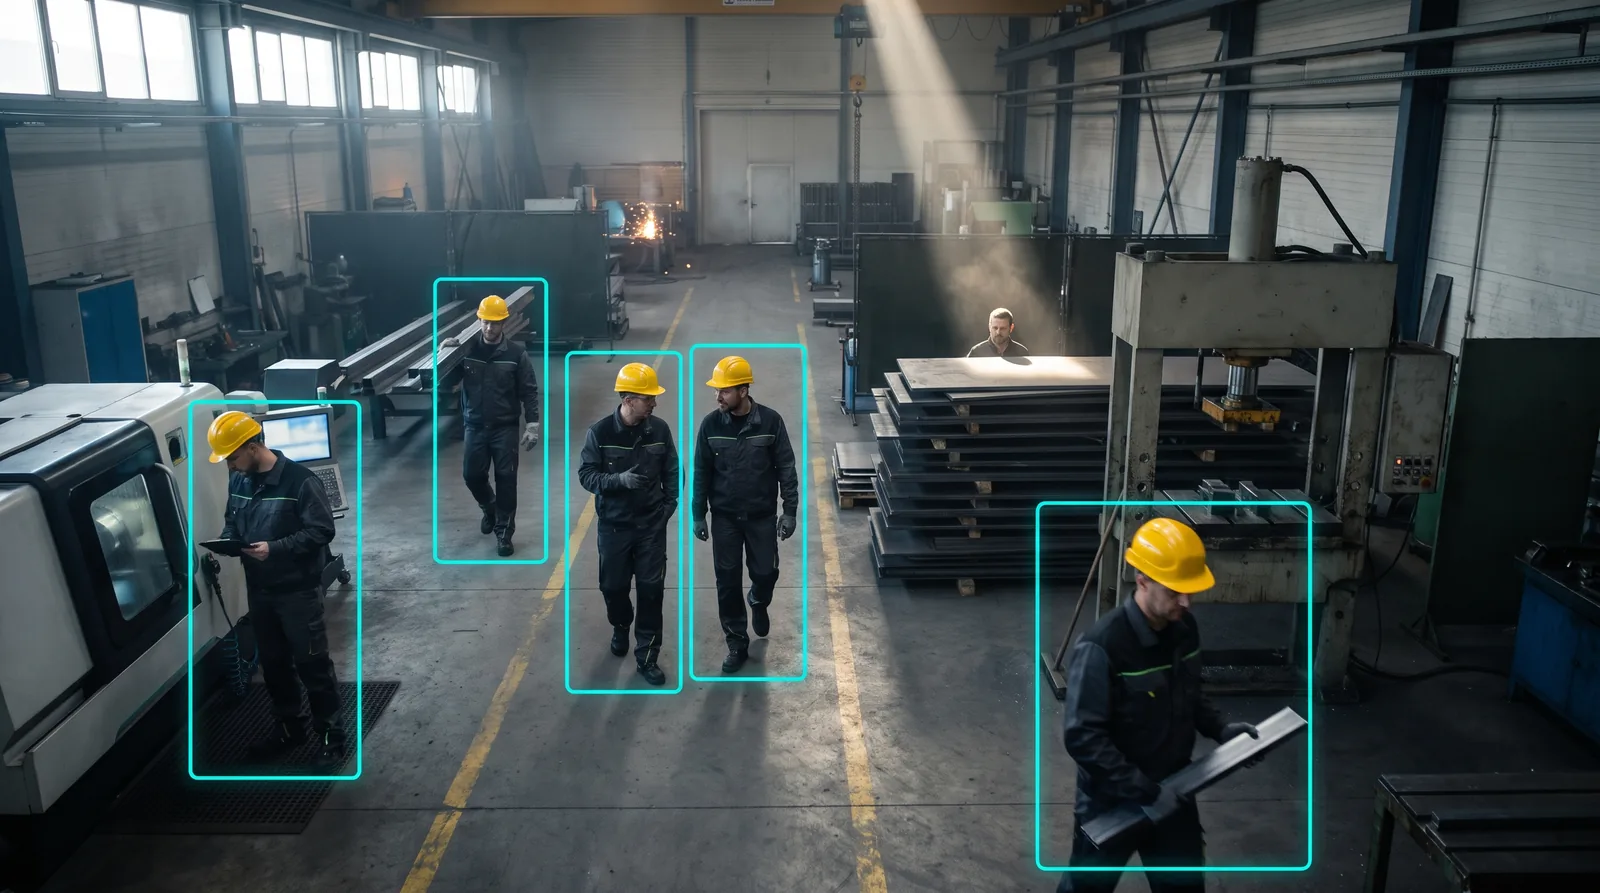
Ha egy fémipari üzem kamerákkal ellenőrzi, hogy a dolgozók viselnek-e sisakot, el kell döntenie, elég-e egy kész képfelismerő megoldás, érdemes-e multimodális LLM-et kipróbálni, vagy saját adatokon finomhangolt modellre van szükség.
A kihagyott jelzés veszélyhelyzetet hagyhat észrevétlenül, a felesleges riasztás pedig megszakítja a munkát.
A választás azzal kezdődik, melyik hibából mennyi fér bele.
Kézenfekvő kipróbálni egy előtanított modellt, amely saját tanítóadat nélkül is képes lehet felismerni a sisak hiányát. Néhány sikeres találat azonban kevés: a háttérben, takarásban álló dolgozó könnyen kimaradhat.
Ha a kész megoldás teljesíti az elvárásokat, a további tanításnak mérhető előnyt kell adnia. Ehhez a hibákat, a válaszidőt és a teljes költséget ugyanazon a feladaton kell összevetni.
A multimodális LLM is deep learning, és helyben is futhat
Az előtanított képfeldolgozó neurális háló már megtanult képi mintázatokat felismerni.
A saját tanítóadat nélküli használat itt azt jelenti, hogy a modellt nem tanítjuk tovább az adott feladatra.
Ilyen kiindulópont lehet egy képosztályozó vagy egy multimodális, képet is feldolgozó nagy nyelvi modell, azaz LLM.
A futtatás helye külön döntés:
- Felhős API esetén a modellt programból, külső szolgáltatásként érjük el,
- helyi futtatásnál pedig a saját gépünkön fut.
Előtanított és saját adaton finomhangolt megoldás mindkét környezetben működhet.
A futtatás helyétől függetlenül először a feladat határát kell tisztázni: egy emberről készült kivágáson megítélni a sisakviselést osztályozási feladat. A teljes csarnok képén előbb minden érintett dolgozót meg kell találni, ami objektumdetektálást is igényel.
Erre használható például a YOLO modellcsalád megfelelő változata. A detektor befoglaló téglalapokkal (bounding box) jelöli az objektumok helyét, és kategóriát rendel hozzájuk; a felismerhető kategóriák a választott modell tanításától függnek.
A megtalált emberek kivágásait ezután képosztályozó vagy multimodális LLM értékelheti.
Aki az első lépésben kimarad, arról a következő modell sem fog dönteni.
Egy modell jó eredménye önmagában még nem igazolja a teljes rendszer megbízhatóságát.
A hibák értékelése a következményük szerint
A műszakvezetővel még a kísérlet előtt fontos rögzíteni, milyen helyzet váltson ki jelzést, mennyi késés fér bele, és ki ellenőrzi a riasztásokat. Ezekből következik az elfogadható hibahatár, amelyhez később minden jelöltet mérni lehet.
A hibahatár ellenőrzésénél az összesített helyes besorolási arány, az accuracy félrevezető lehet, ha a felvételek túlnyomó részén mindenki sisakot visel. Ilyenkor egy szabálytalanságokat rendszeresen elnéző modell is kedvező értéket érhet el.
A sisakhiányt pozitív esetként kezelve ezek a mutatók segítenek:
- Recall: A tényleges sisakhiányok mekkora részét találja meg a rendszer?
- Precision: A sisakhiányt jelző találatok mekkora része helyes?
- Téves riasztások műszakonként: Mennyi felesleges ellenőrzés jut a munkatársakra?
- Jelzésig eltelt idő: Milyen gyorsan jut el a figyelmeztetés az illetékeshez?
Az F-score a precision és a recall közös értékelését segíti, de a kihagyott veszélyhelyzeteket és a téves riasztásokat külön is meg kell mutatni.
A scikit-learn metrikákról szóló dokumentációja alapján is a felhasználás céljához érdemes mérőszámot választani.
Videónál azt is érdemes rögzíteni, mi számít egy eseménynek. Ugyanaz a sisak nélküli dolgozó több egymást követő képkockán szerepelhet, ezért a képkockánkénti eredmény mellett az önálló veszélyhelyzetek felismerését és az ismétlődő riasztások számát is vizsgálni kell.
A közös tesztadat többet ér a látványos demónál
A hibák összehasonlítható méréséhez egyértelmű annotáció kell, ami a képhez rendelt címkét vagy jelölést jelenti, amelyhez a modell eredményét hasonlítjuk.
A címkézési útmutató rögzítse a sisakviselés, a sisakhiány és a nem eldönthető eset szabályait, hogy takarásnál minden címkéző ugyanazt az elvet kövesse.
A modelleket ugyanazokon az elkülönített felvételeken hasonlítjuk össze. A beállításokat validációs adatokon választjuk ki, a végső tesztet pedig külön tartjuk. Ha újra és újra a teszteredményhez igazítjuk a módosításokat, torzulhat az értékelés.
Az adatok elkülönítésénél egy videórészlet szomszédos képkockái maradjanak egy adatrészben. Külön vizsgáljuk a rossz fényt, a takarást és a távoli embereket, valamint közöljük a nem eldönthető esetek arányát. Így láthatóvá válik, milyen körülmények között használható a rendszer.
A tesztben külön összegyűjtjük azokat a veszélyhelyzeteket, amelyeknél elmaradt a jelzés. Ezek átnézése segít eldönteni, milyen hibák javítására érdemes a következő lépésben összpontosítani.
A finomhangolás konkrét hibára adjon választ
Ha a mérések alapján finomhangolás indokolt, a saját modellhez nem kell nulláról indulni. A transfer learning a korábbi tanítás eredményét használja fel az új feladathoz; erre konvolúciós neurális háló, azaz CNN, illetve Vision Transformer, röviden ViT is alkalmas lehet.
Kevés, az előtanítás adataihoz hasonló kép esetén jó kiindulás a meglévő képi jellemzőkre épített új osztályozó tanítása. Több adat mellett további rétegek finomhangolása is indokolttá válhat. A tanítható paraméterek körét az adatmennyiség, a feladat hasonlósága és a túltanulás veszélye együtt befolyásolja.
Az üzemben egy visszatérően félreismert sisaktípus indokolhat ilyen próbát. Előre rögzítjük, melyik hibacsoportban várható javulás, majd az elkülönített teszten ellenőrizzük az eredményt.
Teljesen kitakart fejnél viszont a sisakviselés az adott képből nem állapítható meg megbízhatóan. Ilyenkor a kamera áthelyezése segíthet. Ha pedig az emberek megtalálása hibás, a kivágások osztályozójának javítása érintetlenül hagyja a problémát.
Ha a feltárt hiba finomhangolással javítható, a megvalósításhoz a csapat tapasztalata és a kiválasztott modell támogatása alapján választhatunk a PyTorch, a TensorFlow és a Keras közül.
A teljes működés sebessége és költsége
A válaszidőbe a képek előkészítése, továbbítása, a várakozás és a riasztás célba juttatása is beleszámít. A célgépen, a tervezett kameraterheléssel mérünk, és figyeljük a ritkább, hosszú késéseket, valamint a memóriaigényt.
Forintban, ugyanarra az időszakra összesítjük:
- a szolgáltatás vagy a helyi hardver költségét,
- a fejlesztést,
- az annotációt
- és az emberi ellenőrzést.
Az utolsó tételnél a havi ellenőrzési időt megszorozzuk a belső óraköltséggel, hogy a téves riasztások munkaidőigénye is láthatóvá váljon.
A költség mellett a futtatási környezet kiválasztásához az adatkezelés feltételeit is át kell tekinteni. Helyi futtatásnál is tisztázni kell az azonosítható dolgozókról készült felvételek kezelését: a célt, a jogalapot, a hozzáférést és a megőrzés idejét. Ehhez az Európai Adatvédelmi Testület videós adatkezelési útmutatója ad GDPR-szempontokat.
A legkisebb megfelelő modell keresése jó döntési cél. A korábban rögzített hibahatárt és válaszidőt teljesítő jelöltek közül a teljes költség alapján választunk.
A döntések gyakorlása saját deep learning projektben
A Deep Learning a gyakorlatban képzésünkön önálló portfólióprojektben építhetsz saját deep learning modellt.
A képzés azoknak szól, akik már dolgoztak Pythonnal és gépi tanulási alapokkal, és a deep learning gyakorlati alkalmazásában szeretnének továbblépni.
A sisakellenőrzési példában felmerült mérési kérdésekhez a validáció, a confusion matrix, valamint az accuracy, precision, recall és F-score feldolgozása kapcsolódik. Ezek adnak alapot ahhoz, hogy megvizsgáljuk, milyen hibákat fed el az összesített eredmény, és melyik mérőszám illik a feladathoz.
A computer vision tananyag áttekinti az osztályozást, az objektumdetektálást és a szegmentálást.
A CNN-gyakorlat, valamint a Vision Transformerhez kapcsolódó transfer learning és data augmentation gyakorlat a saját feladathoz igazítást alapozza meg. Utóbbiban a tanítópéldák módosított változataival dolgozol.
Ha a csapatod is képfelismerő projekt előtt áll, érdemes a vezetőddel megbeszélni a közös részvételt: az adatlapon cégként is érdeklődhettek.
Itt találod a Deep Learning a gyakorlatban képzésünk teljes tematikáját és részleteit.
A lényeg röviden
- Rögzítjük az elfogadható hibahatárt, a válaszidőt és a riasztások ellenőrzésének menetét.
- Ugyanazokon az elkülönített felvételeken mérjük a teljes rendszert, a nehéz eseteket külön is vizsgálva.
- A finomhangolást konkrét, javítható hibák indokolják.
- A futtatás mellett az emberi ellenőrzés és a fejlesztés költségével is számolunk.
Kapcsolódó cikkek
Iratkozz fel a hírlevelünkre!
Heti tippek, képzési hírek, kedvezmények — spam nélkül.
Tetszett? Oszd meg!
Segíts másoknak is megtalálni ezt a cikket.